Что резюме говорит
о человеке
Извлечение ключевых слов и именованных сущностей из 13 389 резюме
Проектная работа по NLP, вариант 7
Тема, акцент NER. План: данные, пайплайн, TF-IDF, W2V, демо
Задача
Рекрутер открывает резюме и за минуту должен понять: кто это, что умеет и на какую вакансию подходит.
- 1Достать навыки и инструменты
- 2Найти организации, места, продукты
- 3Скрыть личные данные
- 4Подобрать похожих кандидатов
Неструктурированный OCR-текст → структура. Контакты скрываю первым шагом
Корпус
13 389резюме
43профессии
8,76 млнслов
654слова в среднем на резюме
Resume-Classification-Dataset, лицензия MIT. Тексты получены OCR из Google Images, Bing Images и LiveCareer.
Внутри: OCR-мусор, разорванные слова, 1 024 точных дубликата, e-mail и телефоны.
13 389 / 43 / 8,76 млн. MIT. Мусор OCR, 1 024 дубля, контакты
Пайплайн
Маскирование
PII
Очистка
Лемматизация
spaCy
TF-IDF
NER
Word2Vec
Было
Contact: j.smith@mail.com, +1 (415) 555-0199. Managed SQL databases ____
Стало
contact [EMAIL] [PHONE] manage sql database
clean_text общий. Регулярки → [EMAIL] [PHONE]. Стоп-слова + resume, experience
Пайплайн
Маскирование
PII
Очистка
Лемматизация
spaCy
TF-IDF
NER
Word2Vec
97,6%резюме с замаскированными контактами
−30,6%токенов после очистки
252k → 80kразмер словаря
Стемминг NLTKstudies → studi
Лемма spaCystudies → study
Совпадают только в 1,3% случаев. Для ключевых слов берём леммы: это настоящие слова.
97,6% замаскировано. −30,6% токенов. Словарь 252k → 80k. studi vs study, 1,3%
TF-IDF находит то, что отличает профессию
Маскирование
PII
Очистка
Лемматизация
spaCy
TF-IDF
NER
Word2Vec
| Data Science | machinelearningmodelscience |
|---|
| SAP Developer | sapabapbwbusiness |
|---|
| Accountant | financialtaxreconciliationstatement |
|---|
| Civil Engineer | constructionsitecontractorsurvey |
|---|
BOW: management, team у всех. TF-IDF штрафует общее. В демо так же
Word2Vec понимает контекст резюме
Маскирование
PII
Очистка
Лемматизация
spaCy
TF-IDF
NER
Word2Vec
Наша модель на резюме
python numpy, django, pyspark
nurse rn, nursing, registered
autocad revit, solidworks, cad
GloVe на Википедии
python php, perl
sql postgresql, query
Общий язык, а не язык рекрутинга
Своя модель: numpy, django. GloVe: php, perl. fastText спасает OCR-опечатки
Поиск похожих резюме: гибрид работает лучше
Случайный выбор0,025
Word2Vec0,497
TF-IDF0,551
Гибрид α = 0,60,566
12 017 в индексе. α смешивает. 0,566 vs 0,025, в 20+ раз. Метки шумные
Чем построены графики
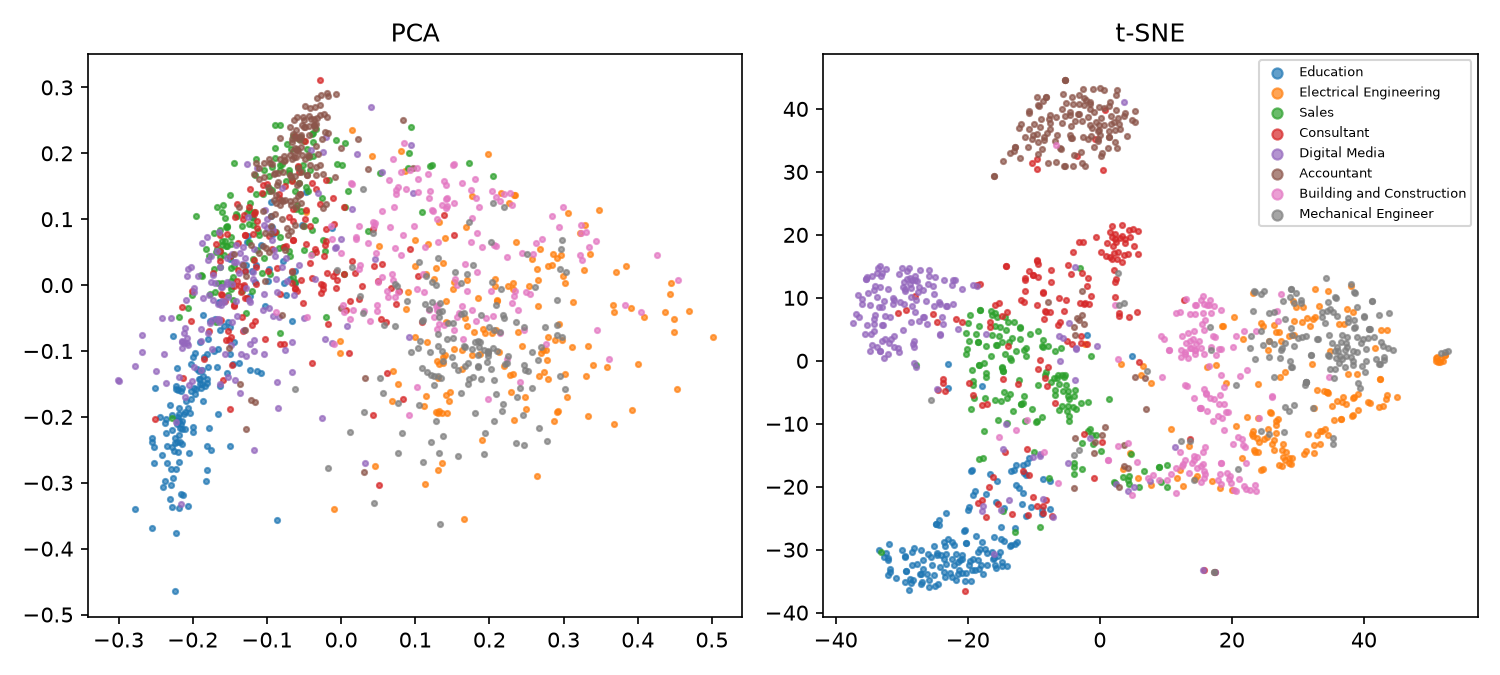 Векторы резюме, 8 крупнейших профессий по 150 резюме: PCA слева, t-SNE справа
matplotlib везде. Облака: wordcloud. t-SNE perplexity 30, init pca, seed 7. Документ = TF-IDF-взвешенное среднее Word2Vec
Демо
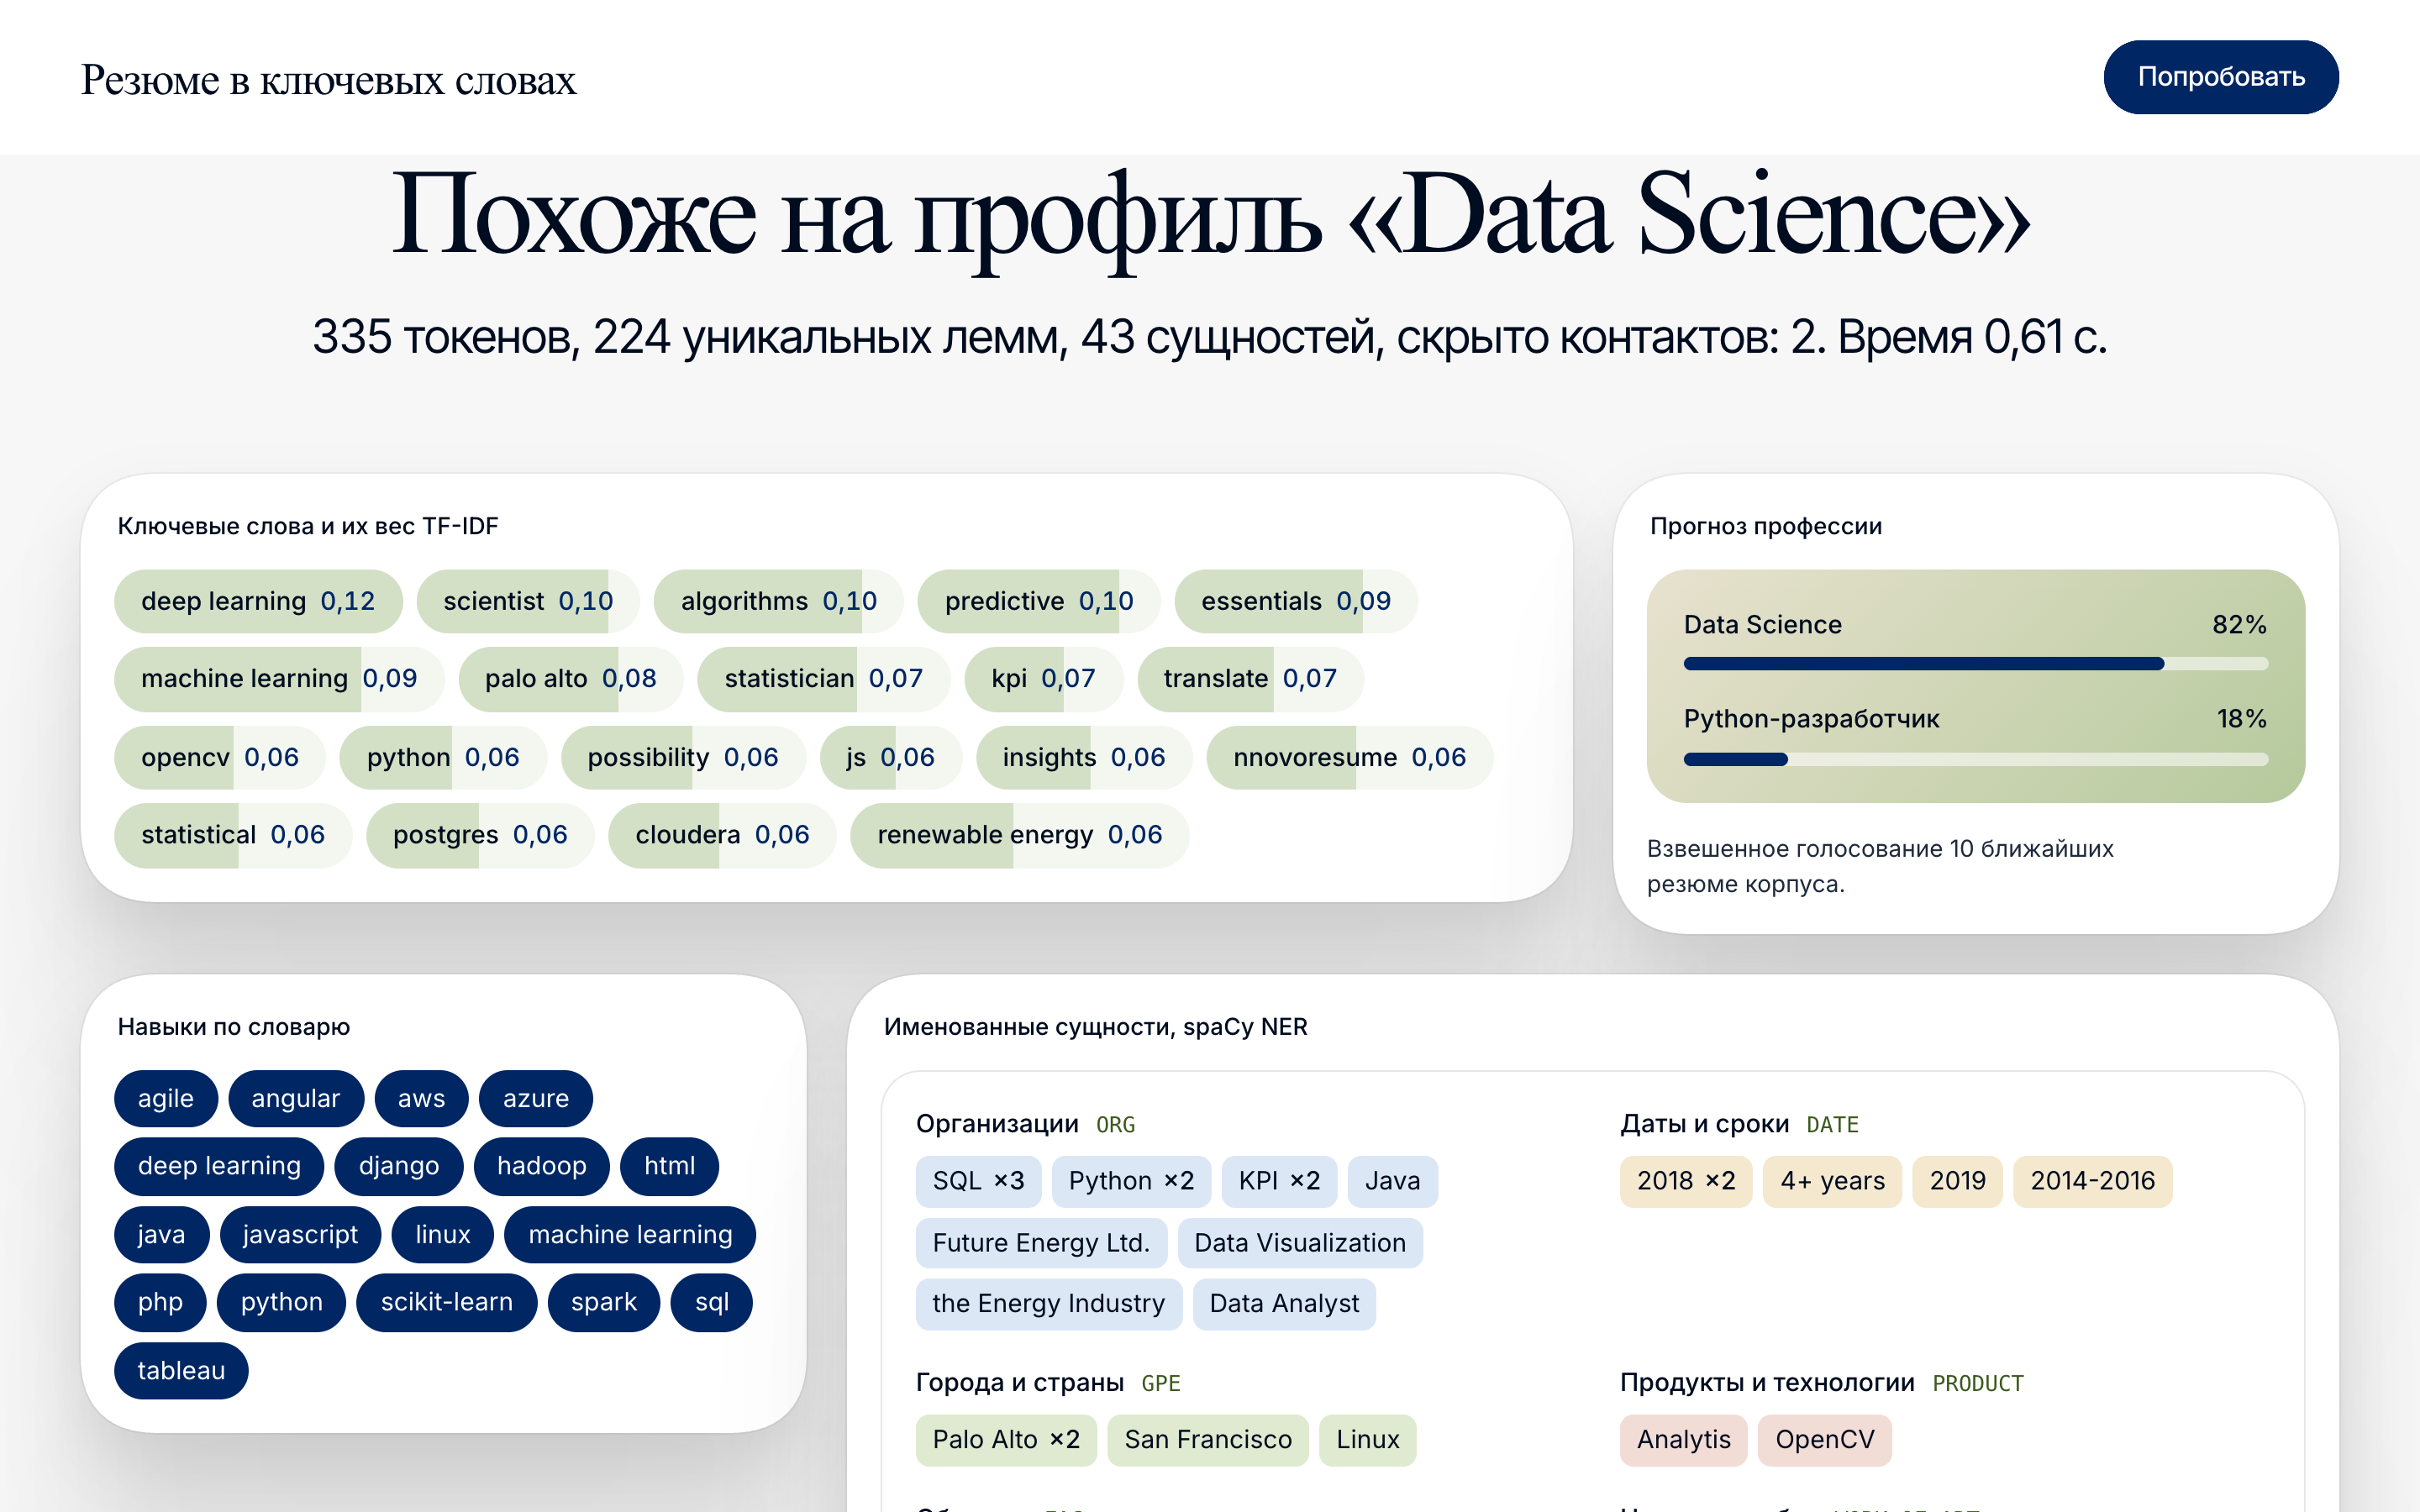
Вставляем резюме или прикрепляем PDF.
Получаем ключевые навыки с весами, сущности по типам, профессию и похожих кандидатов.
localhost:3010
Вкладка 3010. Пример → контакты скрыты → слова → NER → категория → похожие
Итог
- Полный цикл на 13 389 резюме: от OCR-текста до векторов
- Контакты маскируются в 97,6% документов
- Ключевые слова и сущности для любого резюме
- Поиск кандидатов: Precision@10 = 0,566 против 0,025
Дальше
Скрывать имена и адреса через NER
Разметка релевантности рекрутерами
Трансформерные эмбеддинги вместо Word2Vec
Спасибо. Готов ответить на вопросы.
Итог за 30 сек. Дальше: NER для имён, разметка, трансформеры. Спасибо